Casa/Blog/Tecnologia/Amazon relata demanda crescente de chips personalizados Graviton e Trainium
Chips e hardware de computaçãoConfirmado.
Amazon relata demanda crescente de chips personalizados Graviton e Trainium
O CEO da Amazon, Andy Jassy, revela crescimento robusto e de três dígitos na demanda por seus chips personalizados Graviton e Trainium, ressaltando seu papel crítico na aceleração do desempenho da AWS e na capacidade de IA.
Publicado em 1 de novembro de 20263 minutos de leitura.Chips e hardware de computação
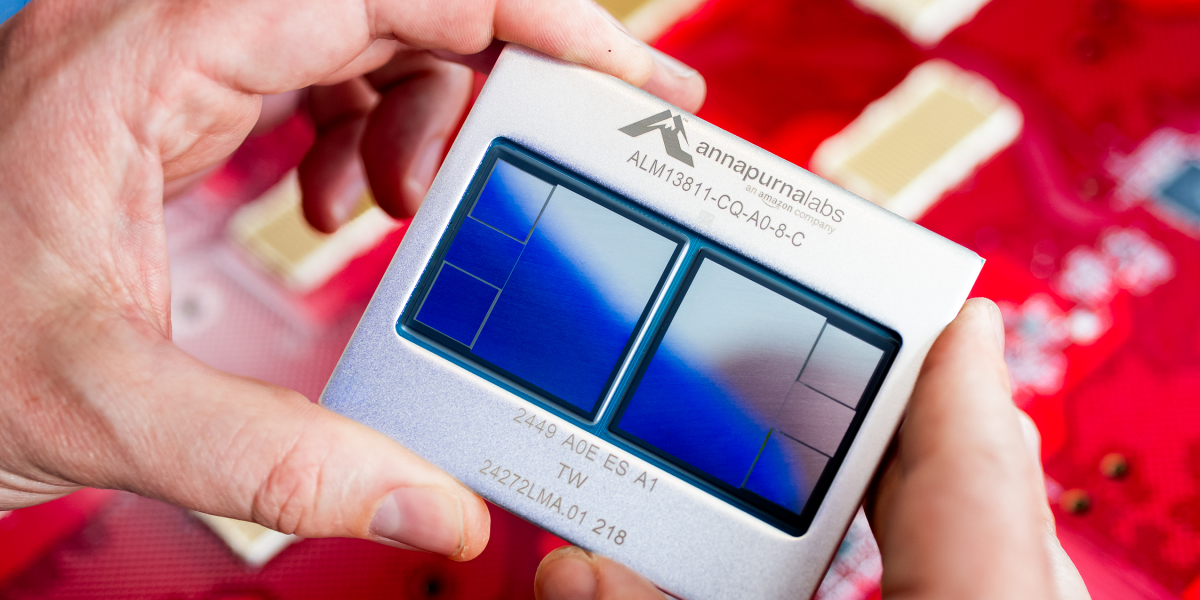
Durante a chamada de ganhos Q3 2026 da Amazon em 30 de outubro, o CEO Andy Jassy afirmou que a demanda por chips personalizados da empresa — Graviton ( CPUs de uso geral) e Trainium (aceleradores de IA) — continua a crescer em percentuais de três dígitos ano após ano. Os compromissos de receita para ambas as famílias de chips aumentaram mais de 20 × ano ao longo do ano, indicando adoção substancial de clientes e volume de contrato de longo prazo.
Jassy destacou que as cargas de trabalho de IA são um importante motorista para a adoção Graviton. Ele explicou que pós-treinamento, aprendizagem de reforço, e ferramenta de agente usam principalmente em CPUs, onde Graviton oferece desempenho de preço superior em comparação com instâncias baseadas em x86 alternativas. Isso posiciona Graviton como um componente chave da infraestrutura de IA além de apenas inferência servindo.
A Amazon também anunciou planos para disponibilizar aceleradores de trem fora da AWS no final de 2027, citando forte demanda de clientes por instalações ou implantação híbrida. A empresa tem TorchNeuron de código aberto, uma integração PyTorch que permite que os desenvolvedores executem modelos PyTorch existentes no Trainium com mudanças de código mínimas, reduzindo a barreira de entrada para equipes avaliando o acelerador.
Aumento da demanda ano após ano por Graviton e Trainium.
Compromissos de receita acima de 20 x ano ao longo do ano para cada linha de chip.
Graviton favoreceu o pós-treinamento de IA, RL e ferramentas de agentes devido ao desempenho de preço da CPU.
Disponibilidade externa de trem para o final de 2027.
TorchNeuron, fonte aberta para facilitar a migração de PyTorch para Trainium.
Análise técnica
O crescimento sustentado de três dígitos na demanda personalizada de silício reflete uma estratégia de chip interno que aborda diretamente a economia das cargas de trabalho em nuvem em grande escala. A arquitetura baseada em armas de Graviton já demonstrou um desempenho de preço atraente para computação de propósito geral, sua extensão em estágios pesados de CPU adjacentes a IA (pós-treinamento, aprendizagem de reforço, orquestração de agentes) sugere que a AWS está otimizando o oleoduto em vez de se concentrar apenas no treinamento pesado de aceleradores. Isso se alinha com a tendência observada na indústria, onde as fases ligadas à CPU — pré-processamento de dados, compilação de modelos e serviço de inferência — constituem uma parcela crescente do custo total de computação de IA.
A disponibilidade externa planejada do trainium no final de 2027 indica uma mudança estratégica da diferenciação de serviço de nuvem pura para um modelo de negócios de silício mais amplo. Para engenheiros, isso levanta questões práticas sobre portabilidade de software: o open-sourcing de TorchNeuron é um passo concreto para reduzir o bloqueio de fornecedores, mas a maturidade do ecossistema (bibliotecas de Kernel, ferramentas de perfil, depuradores) determinará a velocidade de adoção do mundo real. Equipes que avaliam o Trainium devem comparar suas cargas específicas de trabalho PyTorch com o Neuron SDK hoje, como características de desempenho diferem das GPUs NVIDIA na hierarquia de memória, utilização de núcleo de tensor e caminhos de otimização de compiladores.
The >20× revenue commitment growth implies that enterprise customers are signing multi-year capacity reservations, which in turn gives AWS predictable demand signals for fab capacity planning. This feedback loop — custom silicon → better price-performance → larger commitments → more aggressive roadmap investment — is a classic flywheel that can widen the total cost of ownership gap versus merchant silicon. However, the absence of disclosed performance-per-watt figures, die sizes, process nodes, or yield data means external analysts cannot independently verify the architectural efficiency claims. Developers should treat the price-performance advantage as a workload-dependent variable and run representative benchmarks before committing to architecture migrations.
A expansão de Graviton em estágios de CPU de IA reflete a otimização de tubos completos.
As vendas externas indicam uma mudança de estratégia de silício como produto.
TorchNeuron reduz, mas não elimina o esforço de portagem.
Compromissos de receita permitem planejamento a longo prazo e aceleração do roteiro.
Verificação independente de pedidos de eficiência não é possível sem dados microarquiteturais divulgados.
Para engenheiros de software visando AWS, a trajetória de crescimento de Graviton e Trainium tem consequências práticas imediatas. As instâncias de EC2 baseadas em graviton (por exemplo, C7g, R7g, M7g) são agora opções padrão para muitas cargas de trabalho de contêineres e sem servidores; oleodutos CI/CD, frotas de construção, e microservices muitas vezes vêem redução de custos de 20-40% com recompilação ou reconstruções de imagens de container para Arm64. A nota específica da IA sobre o aprendizado pós-treinamento e reforço sugere que equipes executando RLHF, DPO, ou frameworks de agentes (por exemplo, LangChain, AutoGPT) devem avaliar instâncias Graviton para essas etapas, potencialmente reservando instâncias de Trainium ou GPU apenas para as fases de multiplicação de matrizes pesadas.
No lado Trainium, a integração Neuron SDK e TorchNeuron significa que os modelos PyTorch podem ser compilados para a arquitetura NeuronCore do Trainium via 'torch neuronx' ou o caminho mais novo 'torch xla'. No entanto, desenvolvedores devem considerar diferenças em operadores suportados, manipulação dinâmica de formas e gerenciamento de memória. A linha do tempo de disponibilidade externa do final do ano 2027 está distante o suficiente para que a maioria das equipes se engaje pela AWS primeiro, aqueles com rígidos requisitos de residência ou latência de dados devem fatorar isso em roteiros de infraestrutura de vários anos.
As instâncias Graviton oferecem uma economia de 20% a 40% para cargas de trabalho compatíveis com Arm64.
AI pós-treinamento e RL estágios são ligados à CPU e beneficiar de Graviton preço-desempenho.
O desenvolvimento de treinamento requer AWS, hardware externo não esperado até o final de 2027.
A cobertura do operador neuron SDK e o suporte dinâmico são critérios práticos de avaliação.
 Chips e hardware de computaçãoConfirmado.
