Casa/Blog/Tecnologia/Meta's Muse Spark Open Model para codificação agentic agora no AWS SageMaker JumpStart IA e modelos, engenharia de software, plataformas de nuvemConfirmado.Meta's Muse Spark Open Model para codificação agentic agora no AWS SageMaker JumpStart
O Meta's Muse Spark Open, um poderoso modelo de IA para codificação agente, está agora disponível no Amazon SageMaker JumpStart, oferecendo recursos avançados para engenharia de software empresarial.
Publicado em 15 de outubro de 202611 minutos de leitura.IA e modelos, engenharia de software, plataformas de nuvem
Fatos confirmados.
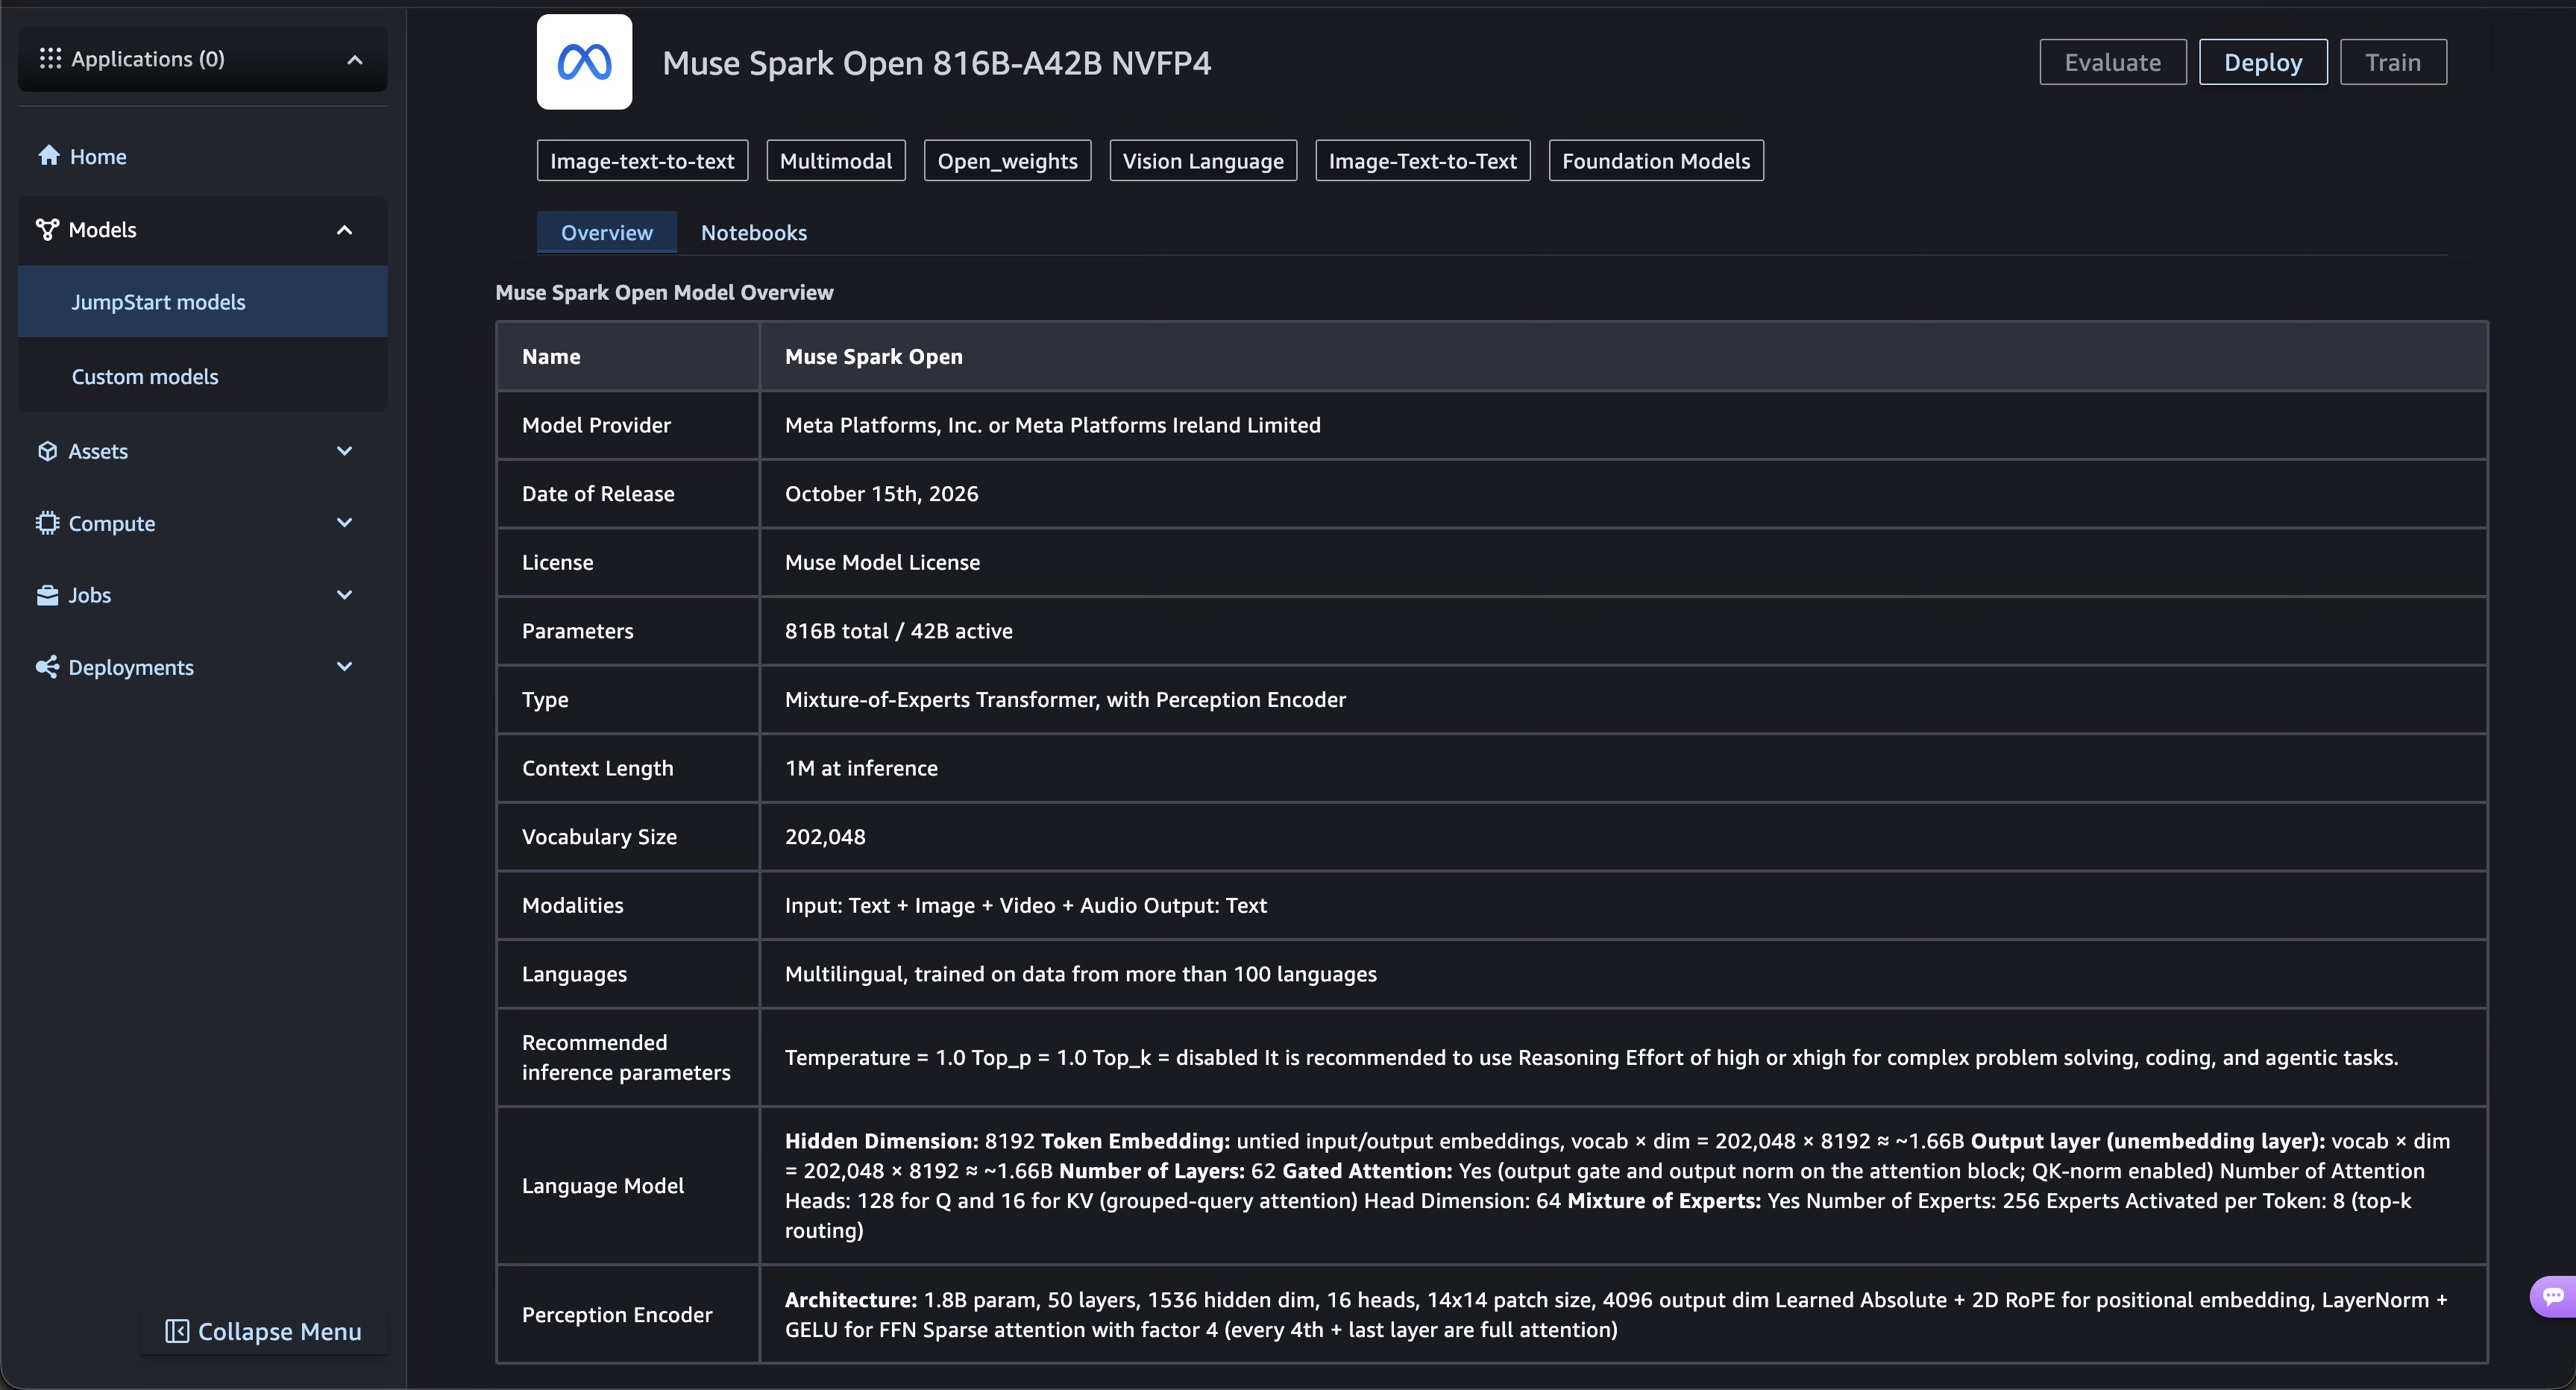
O modelo do Meta's Muse Spark Open está disponível no Amazon SageMaker JumpStart. Este modelo é uma oferta de peso aberto da Meta, especificamente otimizada para fluxos de trabalho de codificação. Ele é projetado para apoiar o raciocínio multi-passo e a chamada de ferramentas dentro de contextos de engenharia de software empresarial na infraestrutura AWS. A arquitetura do Muse Spark Open é confirmada como um modelo Mixture-of-Experts (MoE), com 816 bilhões de parâmetros totais com 42 bilhões de parâmetros ativos por token. Uma característica significativa desse modelo é sua janela de contexto de 1 milhão de token, que permite processar extensas quantidades de informação, incluindo projetos inteiros, dependências, código legado e milhares de arquivos, sem exigir que as tarefas sejam divididas em segmentos menores. O modelo é capaz de aceitar diversas modalidades de entrada, incluindo texto, imagens, documentos, áudio e áudio-vídeo, enquanto gera saída de texto. Seu treinamento focado em fluxos de trabalho de desenvolvedores do mundo real, como refatoração de arquivos múltiplos e sessões de depuração estendidas, permitindo planejar, executar ações, observar resultados, e auto-correção em horizontes operacionais prolongados, ao invés de realizar apenas chamadas de ferramentas.
Para implantação em SageMaker JumpStart, duas variantes distintas de Muse Spark Open são fornecidas: uma variante BF16, identificada como Muse-Spark-Open-816B-A42B, e uma variante quantizada NVFP4, chamada Muse-Spark-Open-816B-A42B-NVFP4. A variante quantizada NVFP4 oferece uma vantagem notável ao exigir aproximadamente um quarto da memória em comparação com a versão BF16, facilitando uma implantação mais econômica. Os clientes podem implantar Muse Spark Open através de SageMaker JumpStart com um processo simplificado, tipicamente envolvendo alguns cliques. Após a implantação, o ponto final do modelo opera dentro da própria conta do cliente AWS, concedendo-lhes controle total sobre seu código fonte e alertas. Acesso para implantar e utilizar o modelo está disponível através do catálogo do modelo SageMaker JumpStart dentro do console SageMaker ou programaticamente usando o SageMaker Python SDK.
Análise técnica
A introdução do Meta's Muse Spark Open na Amazon SageMaker JumpStart representa um notável desenvolvimento para práticas de engenharia de software alavancando inteligência artificial. As características confirmadas deste modelo – um status de peso aberto, uma arquitetura Mixture-of-Experts (MoE), uma janela de contexto excepcionalmente grande, recursos de entrada multimodal e otimização para fluxos de trabalho de codificação agente – apontam coletivamente para uma mudança em como os desenvolvedores podem interagir e integrar IA em tarefas complexas de desenvolvimento de software. A disponibilidade no SageMaker JumpStart define ainda mais o contexto operacional, enfatizando a facilidade de implantação e controle do cliente em um ambiente de nuvem. Analisar essas características confirmadas permite uma compreensão das consequências práticas da engenharia, possíveis transformações de fluxo de trabalho, e as vantagens específicas oferecidas por este modelo particular projeto e estratégia de implantação, tudo ligado diretamente às evidências fornecidas.
A combinação de uma grande contagem de parâmetros com uma eficiente arquitetura MoE, juntamente com uma janela de contexto capaz de ingerir projetos inteiros, enfrenta vários desafios de longa data na aplicação de IA para o desenvolvimento de software em grande escala. Além disso, o fornecimento de uma variante quantizada impacta diretamente na viabilidade econômica e prática de implantar um modelo tão poderoso. Entender esses fundamentos técnicos é crucial para engenheiros de software considerando a adoção de modelos avançados de IA para tarefas que vão desde a geração de código e refatoração até a complexa depuração e análise arquitetônica. Esta análise se concentrará nas consequências diretas e deriváveis para desenvolvedores e equipes de engenharia, fundamentadas estritamente nos detalhes confirmados fornecidos pela fonte, sem introduzir qualquer especulação não apoiada.
A Arquitectura da Mistura de Especialistas na Prática
O uso confirmado de uma arquitetura Mixture-of-Experts (MoE) para Muse Spark Open, com 816 bilhões de parâmetros totais e 42 bilhões ativos por token, tem implicações significativas para suas características operacionais e utilidade prática em engenharia de software. Um projeto MoE permite fundamentalmente que um modelo possua uma vasta capacidade de conhecimento, representada pela contagem total de parâmetros, mantendo uma pegada computacional mais controlável para pedidos de inferência individuais. O detalhe confirmado de que apenas 42 bilhões de parâmetros estão ativos por token significa que, para qualquer sinal de entrada, apenas um subconjunto dos "especialistas" do modelo estão envolvidos. Esta escolha de projeto aborda diretamente o desafio de escalar grandes modelos de linguagem: alcançar alta capacidade sem incorrer no custo computacional proibitivo de ativar todos os parâmetros para cada operação.
De uma perspectiva de engenharia, esta arquitetura sugere que Muse Spark Open pode potencialmente alavancar uma ampla e profunda compreensão de conceitos de programação, diversas bases de código, e vários paradigmas de engenharia de software, como implícito por seus 816 bilhões de parâmetros totais. Simultaneamente, o custo de computação per-token, estando mais próximo do de um modelo denso de 42 bilhões de parâmetros, indica um uso mais eficiente dos recursos computacionais durante a inferência. Esta eficiência é crítica para aplicações do mundo real, particularmente em cenários envolvendo sequências longas ou requisitos de alto rendimento, que são comuns em fluxos de trabalho de codificação agente. A estrutura do MoE, portanto, permite que o modelo seja abrangente em sua base de conhecimento e relativamente eficiente em sua execução, um equilíbrio que é altamente benéfico para tarefas complexas de desenvolvimento de software. O que não foi revelado são os mecanismos específicos de roteamento ou o número de especialistas utilizados dentro desta arquitetura MoE, nem quaisquer parâmetros de desempenho específicos relacionados com sua operação MoE.
Aproveitando a janela de contexto de 1 milhão
A janela de contexto confirmada de 1 milhão de token do Muse Spark Open representa um avanço substancial para o desenvolvimento de software guiado por IA. Esta capacidade permite que o modelo 'ingest um projeto inteiro, incluindo dependências, código legado, e milhares de arquivos, sem dividir tarefas em pedaços menores', como afirma o anúncio. Para engenheiros de software, essa capacidade altera fundamentalmente a abordagem de fornecer contexto para assistentes de IA. Tradicionalmente, os desenvolvedores tiveram que selecionar meticulosamente e fornecer trechos de código relevantes, documentação, ou diagramas arquitetônicos para um modelo de IA, muitas vezes restrito por limites de contexto muito menores. A janela de 1M alivia esse fardo, permitindo uma compreensão mais holística de uma base de código.
As conseqüências práticas da engenharia são profundas. Ao realizar operações complexas como refatores de arquivos ou sessões de depuração, o modelo pode manter uma visão abrangente de todo o estado do projeto. Isso reduz a probabilidade de introduzir inconsistências ou negligenciar dependências que podem residir em arquivos não explicitamente fornecidos em um contexto menor. Por exemplo, durante um refator que abrange vários módulos, o modelo pode considerar simultaneamente as implicações em todos os arquivos afetados, garantindo compatibilidade da API e lógica consistente. Da mesma forma, na depuração, a capacidade de ingerir um projeto inteiro permite que o modelo rastreie problemas em partes díspares do sistema, potencialmente identificando causas de raiz que seriam perdidas por uma análise mais localizada. Essa ampla consciência contextual suporta modificações de código geradas por IA ou assistidas por IA mais coerentes e confiáveis, abordando diretamente o foco de treinamento confirmado em refatores de arquivos múltiplos e longas sessões de depuração. O que não foi revelado são características específicas de desempenho ou implicações de latência quando opera na capacidade de contexto total de 1 milhão, nem quaisquer limitações específicas sobre os tipos de arquivos ou estruturas de projeto que pode ingerir.
Fluxos de Trabalho de Codificação Agentic e Capacidades de Entrada Multimodal
A otimização de Muse Spark Open para 'workflows de codificação genética' e sua capacidade confirmada de 'planejar, agir, observar resultados, e auto-correção em horizontes longos' significa um movimento além da simples geração de código para uma assistência de desenvolvimento mais autônoma e iterativa. Esse paradigma agente implica que o modelo não é apenas uma ferramenta reativa, mas pode se envolver em raciocínios multi-passos, tomar decisões, executar ações (presumivelmente por meio da chamada de ferramentas, como confirmado), avaliar os resultados, e ajustar sua estratégia. Essa capacidade é particularmente valiosa para tarefas complexas, como "refatores de arquivos múltiplos e longas sessões de depuração", onde uma única resposta instantânea é muitas vezes insuficiente. A capacidade do modelo de "autocorreção" sugere um loop interno de feedback, aumentando sua confiabilidade sobre interações estendidas.
Aumentando ainda mais essas capacidades de agente é o suporte de entrada multimodal confirmado pelo modelo, aceitando texto, imagens, documentos, áudio e áudio-vídeo. Este amplo espectro de entrada permite que os desenvolvedores interajam com o agente de IA usando um conjunto mais rico de fontes de informação. Por exemplo, um engenheiro poderia fornecer uma descrição de texto de um bug, uma imagem de um componente de UI, um documento descrevendo arquitetura do sistema, ou até mesmo uma gravação de áudio-vídeo demonstrando um fluxo de trabalho problemático. A capacidade do modelo de processar essas diversas entradas e gerar saída de texto significa que ele pode sintetizar informações de várias formas de documentação e comunicação do projeto, levando a uma compreensão mais abrangente da tarefa em questão. Esta capacidade multimodal, combinada com raciocínio agentic, fornece uma interface mais natural e poderosa para problemas complexos de engenharia de software, reduzindo a necessidade de desenvolvedores para traduzir manualmente informações diversas em um formato puramente textual para a IA. O que não foi revelado são as ferramentas específicas que o modelo pode chamar ou os mecanismos internos de seus processos de planejamento e autocorreção, nem quaisquer limitações específicas sobre os tipos ou formatos de entradas multimodais que pode efetivamente processar.
Eficiência de implantação: quantificação BF16 e NVFP4
A disponibilidade do Muse Spark Open em duas variantes distintas, quantizadas pelo BF16 e NVFP4, aborda considerações críticas de implantação para usuários corporativos. BF16 (BFloat16) é um formato comum de ponto flutuante para aprendizagem profunda, oferecendo um equilíbrio entre precisão numérica e pegada de memória. A variante NVFP4, no entanto, introduz quantização de 4 bits, que é confirmada para exigir "aproximadamente um quarto da memória" em comparação com a versão BF16. Esta redução significativa na pegada da memória tem consequências diretas e substanciais na engenharia, principalmente impactando a eficiência de custo e acessibilidade de implantar um modelo tão grande.
Para as organizações, o consumo de memória é o principal motor de custos de inferência, particularmente para modelos de linguagem grandes. Ao reduzir os requisitos de memória em aproximadamente 75%, a variante NVFP4 permite a implantação de Muse Spark Open em hardware com menos VRAM, ou permite um maior número de solicitações de inferência simultânea em hardware existente. Isso se traduz em menores gastos operacionais e potencialmente maior rendimento, tornando as capacidades avançadas de codificação de IA mais viáveis economicamente para uma gama mais ampla de clientes da AWS. A escolha entre BF16 e NVFP4 permite que as equipes de engenharia equilibrem precisão e desempenho contra custo e disponibilidade de recursos. Embora a fonte confirme a redução de memória, ela não revela nenhuma diferença de desempenho ou qualidade de saída específica entre as variantes BF16 e NVFP4, que normalmente seria uma consideração ao escolher entre diferentes níveis de quantização. No entanto, o benefício confirmado de "implantação econômica" para NVFP4 destaca sua principal vantagem, inferindo diretamente seu impacto nos custos operacionais.
SageMaker JumpIniciar integração e controle
A implantação do Muse Spark Open através do Amazon SageMaker JumpStart fornece um ambiente estruturado e controlado para as empresas integrarem este poderoso modelo de IA. O processo de implantação confirmado "poucos cliques" simplifica o que poderia ser uma instalação complexa envolvendo provisionamento de infraestrutura, carregamento de modelo e configuração de endpoint. Essa facilidade de acesso reduz a barreira de entrada para equipes de desenvolvimento procurando experimentar ou produzir agentes avançados de codificação de IA. Mais criticamente, a confirmação de que 'o ponto final em sua própria conta AWS para o controle total sobre o código fonte e prompts' aborda preocupações principais sobre privacidade de dados, segurança e propriedade intelectual.
Ao garantir que o endpoint de inferência do modelo opere dentro da conta do cliente, todos os prompts de entrada e saídas geradas permanecem dentro dos limites de segurança definidos pelo cliente. Esta é uma vantagem significativa para a engenharia de software empresarial, onde código proprietário e detalhes sensíveis do projeto são rotineiramente tratados. O 'controlo total sobre código fonte e alertas' implica que os clientes mantêm a propriedade e a governança sobre os dados que fluim através do modelo, o que é essencial para a conformidade e políticas de segurança interna. Este modelo de implantação contrasta com soluções onde os prompts e dados podem ser processados por um serviço de terceiros fora do controle direto do cliente. Embora a fonte não revele recursos de ajuste precisos para o Muse Spark Open, o framework geral SageMaker JumpStart, combinado com controle total sobre o endpoint, fornece uma base robusta para a integração segura e compatível de IA em fluxos de trabalho corporativos. A capacidade de usar o SageMaker Python SDK também permite implantação e gerenciamento programático, facilitando a integração em pipelines CI/CD existentes ou fluxos de trabalho automatizados.
Considerações Práticas de Engenharia para adoção
Para equipes de engenharia de software considerando a adoção do Muse Spark Open, várias considerações práticas emergem diretamente de suas capacidades confirmadas. A otimização do modelo para codificação agente e sua janela de contexto de 1 milhão sugere uma mudança do uso de IA para tarefas isoladas para integrá-lo como um assistente mais contínuo e consciente do contexto. Os desenvolvedores podem explorar alavancando sua capacidade de ingerir projetos inteiros para tarefas que exigem amplo entendimento arquitetônico, como identificar preocupações transversais durante a refatoração ou analisar o impacto de uma mudança em uma grande base de código. As capacidades de entrada multimodal significam que as equipes de engenharia podem experimentar alimentando o modelo de diversas formas de informação do projeto, potencialmente simplificando o processo de integração da IA para um novo projeto ou tarefa.
Ao avaliar Muse Spark Open, os desenvolvedores poderiam realizar testes específicos. Por exemplo, eles podem avaliar seu desempenho em um complexo, refactor multi-arquivo dentro de sua própria base de códigos proprietária, comparando o resultado assistido por IA contra os esforços manuais em termos de precisão, consistência e tempo economizado. Outra avaliação poderia envolver apresentar o modelo com um bug desafiador que abrange vários arquivos e requer depuração iterativa, observando seu plano, agir, observar, autocorreto em ação. Testando sua entrada multimodal, fornecendo uma combinação de código, diagramas arquitetônicos (imagens) e documentos de projeto poderia revelar sua eficácia em sintetizar informações díspares. A escolha entre as variantes BF16 e NVFP4 envolverá uma análise de trade-off entre potenciais economias de recursos e quaisquer diferenças percebidas na qualidade de saída ou latência de inferência, embora a fonte só confirme a redução de memória para NVFP4. O que não foi divulgado são benchmarks de desempenho específicos para qualquer variante, ou orientações detalhadas sobre como melhor estruturar prompts para um comportamento agente ideal em diferentes modalidades.