Home/Blog/Tech/Amazon reporta demanda de chips personalizados Graviton y Trainium
Chips y Hardware de computaciónConfirmado
Amazon reporta demanda de chips personalizados Graviton y Trainium
El CEO de Amazon Andy Jassy revela un crecimiento robusto de tres dígitos en la demanda de sus chips de Graviton y Trainium personalizados, subrayando su papel crítico en las capacidades de AWS para acelerar el rendimiento y AI.
Publicado el 1 de noviembre de 20263 min leerChips y Hardware de computación
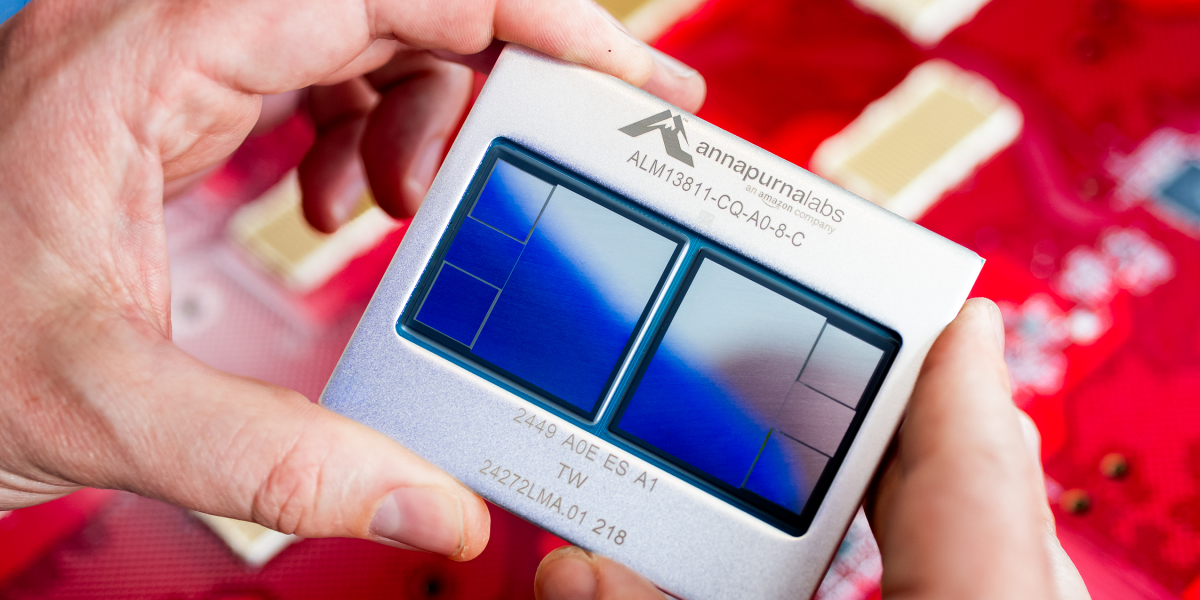
Durante la llamada de ganancias Q3 2026 de Amazon el 30 de octubre, el CEO Andy Jassy declaró que la demanda de las fichas diseñadas a medida de la empresa — Graviton (CPUs de uso general) y Trainium (Aceleradores de IA)— sigue creciendo a tres dígitos por año. Los compromisos de ingresos de ambas familias chip han aumentado más de 20× año a lo largo del año, lo que indica una adopción sustancial de clientes y un volumen de contratos a largo plazo.
Jassy destacó que las cargas de trabajo de IA son un factor importante para la adopción de Graviton. Explicó que el aprendizaje post-entrenamiento, el aprendizaje de refuerzo y el uso de herramientas de agente se ejecutan principalmente en las CPU, donde Graviton ofrece un rendimiento de precio superior en comparación con otros casos basados en x86. Esto posiciona a Graviton como un componente clave de la infraestructura de IA más allá de la inferencia que sirve.
Amazon también anunció planes para que los aceleradores de Trainium estén disponibles fuera de AWS a finales de 2027, citando una fuerte demanda de clientes para instalaciones locales o híbridos. La empresa cuenta con una integración de código abierto TorchNeuron, que permite a los desarrolladores ejecutar modelos existentes de PyTorch en Trainium con cambios mínimos de código, reduciendo la barrera a la entrada para equipos que evalúan el acelerador.
Crecimiento de demanda de triple dígitos año tras año para Graviton y Trainium.
Compromisos de ingresos superiores a año por cada línea de chips.
Graviton favoreció el post-entrenamiento AI, RL y la herramienta de agente debido al rendimiento de precio de la CPU.
Disponibilidad externa de forfacio dirigida a finales de 2027.
TorchNeuron open-sourced to facilitate PyTorch migration to Trainium.
Análisis técnico
El crecimiento sostenido de triple dígitos en la demanda de silicio personalizado refleja una estrategia de chips en la casa que aborda directamente la economía de las cargas de trabajo en la nube a gran escala. La arquitectura de Graviton Arm-based ya ha demostrado un rendimiento de precio convincente para el cálculo de propósito general; su extensión a las etapas de carga de la CPU-adyacente IA (entrenamiento post-entrenamiento, aprendizaje de refuerzo, orquestación de agentes) sugiere que AWS está optimizando el gasoducto completo en lugar de centrarse exclusivamente en la formación de acelerador-corazón. Esto se ajusta a la tendencia observada de la industria en que las fases conducidas por la CPU —preprocesamiento de datos, recopilación de modelos y servicios de inferencia— constituyen una proporción creciente del costo total de la computación de la IA.
La disponibilidad externa prevista de Trainium a finales de 2027 indica un cambio estratégico de la diferenciación del servicio de nube pura a un modelo de negocio de silicio más amplio. Para los ingenieros, esto plantea preguntas prácticas sobre la portabilidad del software: la fuente abierta de TorchNeuron es un paso concreto hacia la reducción del bloqueo del proveedor, pero la madurez del ecosistema (libros de canal, herramientas de perfil, depuradores) determinará la velocidad de adopción del mundo real. Los equipos que evalúan el Trainium deben evaluar sus cargas de trabajo específicas de PyTorch contra el SDK de Neuron hoy, ya que las características de rendimiento difieren de las GPU de NVIDIA en la jerarquía de memoria, la utilización del núcleo de tensor y las vías de optimización del compilador.
El crecimiento del compromiso de ingresos de √20× implica que los clientes empresariales están firmando reservas de capacidad multianual, lo que a su vez da señales de demanda predecibles de AWS para la planificación de la capacidad de fab. Este bucle de retroalimentación — silicio personalizado → mejor rendimiento de precio → compromisos más grandes → inversión de hoja de ruta más agresiva — es un volante clásico que puede ampliar el costo total de la brecha de propiedad contra el silicio mercante. Sin embargo, la ausencia de cifras reveladas de rendimiento por vatio, tamaños de muerte, nodos de proceso o datos de rendimiento significa que los analistas externos no pueden verificar de forma independiente las reivindicaciones de eficiencia arquitectónica. Los desarrolladores deben tratar la ventaja del rendimiento del precio como una variable dependiente del volumen de trabajo y ejecutar parámetros representativos antes de comprometerse a las migraciones de arquitectura.
La expansión de Graviton en las etapas de la CPU de IA refleja la optimización de la línea completa.
Las ventas externas de Trainium indican un cambio de estrategia de silicio como producto.
TorchNeuron reduce pero no elimina el esfuerzo de porte; las brechas de los ecosistemas permanecen.
Los compromisos devengados permiten la planificación a largo plazo de la fab y la aceleración de la hoja de ruta.
La verificación independiente de las reclamaciones por eficiencia no es posible sin datos microarquitectura revelados.
Contexto de ingeniería e impacto del desarrollador
Para los ingenieros de software dirigidos a AWS, la trayectoria de crecimiento de Graviton y Trainium tiene consecuencias prácticas inmediatas. Las instancias EC2 basadas en Graviton (por ejemplo, C7g, R7g, M7g) ahora son opciones predeterminadas para muchas cargas de trabajo containerizzate e inservible; tuberías CI/CD, flotas de construcción y microservicios a menudo ven reducción de costes del 20-40% con recompilación o reconstrucción de imagen de contenedor para Arm64. La nota específica de AI sobre el aprendizaje posterior al entrenamiento y el refuerzo sugiere que los equipos que ejecutan marcos de RLHF, DPO o agentes (por ejemplo, LangChain, AutoGPT) deben evaluar instancias de Graviton para esas etapas, potencialmente reservando casos de Trainium o GPU sólo para las fases de la matriz pesada.
En el lado del Trainium, la integración Neuron SDK y TorchNeuron significa que los modelos PyTorch se pueden compilar en la arquitectura NeuronCore de Trainium a través de `torch neuronx` o el nuevo camino 'torch xla'. Sin embargo, los desarrolladores deben tener en cuenta las diferencias en los operadores soportados, el manejo de forma dinámica y la gestión de memoria. El cronograma de disponibilidad externa a finales de 2027 es lo suficientemente distante que la mayoría de los equipos se comprometerán por primera vez a través de AWS; aquellos con estrictos requisitos de residencia de datos o latencia deben considerar esto en hojas de ruta multianuales de infraestructura.
Las instancias de Graviton ofrecen ahorros de coste del 20-40% para cargas de trabajo compatibles con Arm64.
Las etapas de IA post-entrenamiento y RL están sujetas a CPU y se benefician del rendimiento de los precios de Graviton.
Actualmente, el desarrollo de la formación requiere AWS; el hardware externo no se espera hasta finales de 2027.
La cobertura del operador de neuron SDK y el soporte de forma dinámica son criterios prácticos de evaluación.
 Chips y Hardware de computaciónConfirmado
