Home/Blog/Tech/Modelo abierto de Muse Spark de Meta para Coding Agentic Ahora en AWS SageMaker JumpStart IA y modelos, ingeniería de software, plataformas de nubeConfirmadoModelo abierto de Muse Spark de Meta para Coding Agentic Ahora en AWS SageMaker JumpStart
Meta's Muse Spark Open, un poderoso modelo de IA para codificación de agentes, está ahora disponible en Amazon SageMaker JumpStart, ofreciendo capacidades avanzadas para la ingeniería de software empresarial.
Publicado 15 de octubre de 202611 min leerIA y modelos, ingeniería de software, plataformas de nube
Datos confirmados
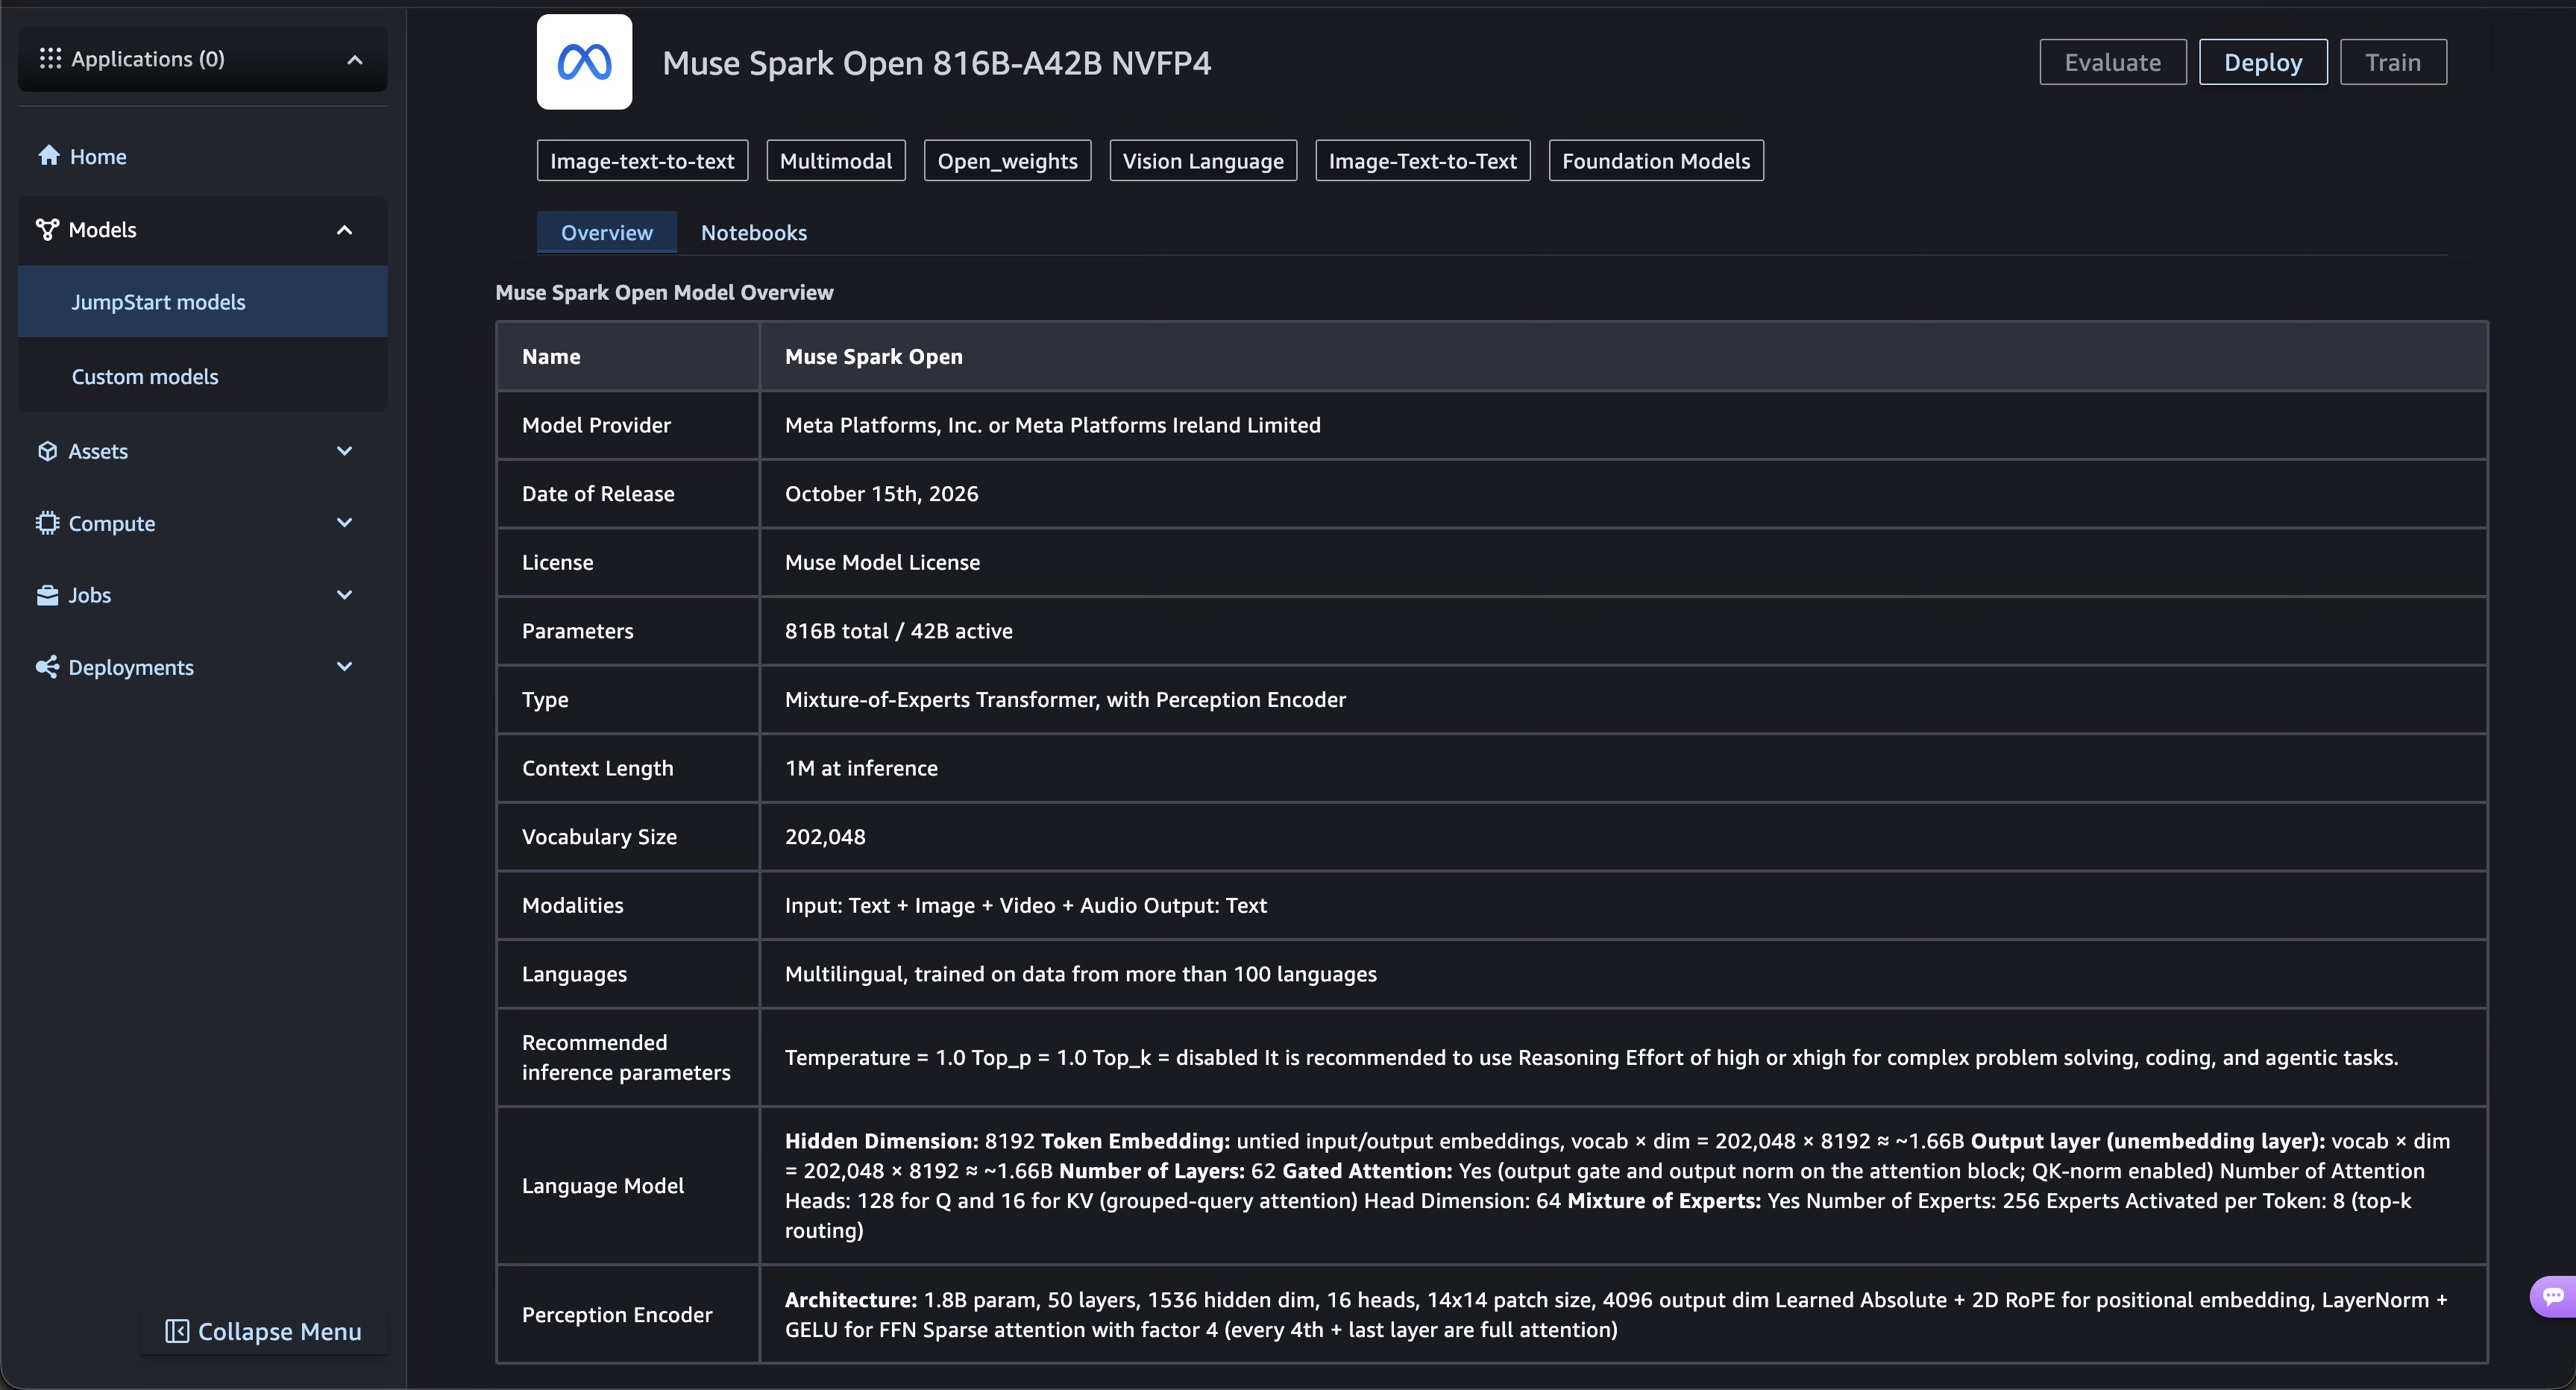
El modelo Muse Spark Open de Meta está disponible ahora en Amazon SageMaker JumpStart. Este modelo es una oferta de peso abierto de Meta, específicamente optimizada para los flujos de trabajo de codificación. Está diseñado para apoyar el razonamiento y la llamada de herramientas de múltiples pasos dentro de contextos de ingeniería de software empresarial en la infraestructura AWS. La arquitectura de Muse Spark Open se confirma como un modelo Mixture-of-Experts (MoE), con 816 mil millones de parámetros totales con 42 mil millones de parámetros activos por token. Una característica significativa de este modelo es su ventana contextual de 1 millón de toneladas, lo que le permite procesar grandes cantidades de información, incluyendo proyectos completos, dependencias, código hereditario y miles de archivos, sin requerir que las tareas se descomponen en segmentos más pequeños. El modelo es capaz de aceptar diversas modalidades de entrada, incluyendo texto, imágenes, documentos, audio y vídeo de audio, generando al mismo tiempo la salida de texto. Su formación se centró en flujos de trabajo de desarrolladores en el mundo real, tales como refactorización de archivos múltiples y sesiones de depuración ampliadas, permitiéndole planificar, ejecutar acciones, observar resultados, y autocorregir sobre horizontes operativos prolongados, en lugar de realizar solo llamadas de herramientas individuales.
Para el despliegue en SageMaker JumpStart, se proporcionan dos variantes distintas de Muse Spark Open: una variante BF16, identificada como Muse-Spark-Open-816B-A42B, y una variante cuantitativa NVFP4, llamada Muse-Spark-Open-816B-A42B-NVFP4. La variante cuantitativa NVFP4 ofrece una ventaja notable al requerir aproximadamente una cuarta parte de la memoria en comparación con la versión BF16, facilitando un despliegue más rentable. Los clientes pueden desplegar Muse Spark Open a través de SageMaker JumpStart con un proceso simplificado, normalmente implicando unos pocos clics. Una vez implementado, el punto final del modelo funciona dentro de la propia cuenta AWS del cliente, concediéndoles el control completo sobre su código fuente y sus indicaciones. El acceso para implementar y utilizar el modelo está disponible a través del catálogo modelo SageMaker JumpStart dentro de la consola SageMaker o programáticamente utilizando el SDK SageMaker Python.
Análisis técnico
La introducción de Meta's Muse Spark Open en Amazon SageMaker JumpStart representa un desarrollo notable para las prácticas de ingeniería de software que aprovechan la inteligencia artificial. Las características confirmadas de este modelo, un estatus de peso abierto, una arquitectura Mixture-of-Experts (MoE), una ventana de contexto excepcionalmente grande, capacidades de entrada multimodal y optimización para flujos de trabajo de codificación agentes, apuntan colectivamente hacia un cambio en cómo los desarrolladores pueden interactuar e integrar la IA en tareas complejas de desarrollo de software. La disponibilidad en SageMaker JumpStart define además el contexto operativo, destacando la facilidad de implementación y el control de clientes dentro de un entorno de nube. Analizar estas características confirmadas permite comprender las consecuencias prácticas de ingeniería, las posibles transformaciones de flujo de trabajo y las ventajas específicas ofrecidas por esta estrategia de diseño y despliegue de modelos, todas vinculadas directamente a las pruebas proporcionadas.
La combinación de un parámetro masivo cuenta con una arquitectura eficiente de MoE, junto con una ventana contextual capaz de ingerir proyectos completos, aborda varios desafíos de larga data en la aplicación de AI al desarrollo de software a gran escala. Además, la provisión de una variante cuantificada afecta directamente a la viabilidad económica y práctica de desplegar un modelo tan poderoso. La comprensión de estos fundamentos técnicos es crucial para los ingenieros de software considerando la adopción de modelos avanzados de IA para tareas que van desde la generación de códigos y la refactorización hasta la depuración compleja y el análisis arquitectónico. Este análisis se centrará en las consecuencias directas y derivadas para los desarrolladores y equipos de ingeniería, basadas estrictamente en los detalles confirmados proporcionados por la fuente, sin introducir ninguna especulación no apoyada.
La mezcla de los expertos (MoE) Arquitectura en la práctica
El uso confirmado de una arquitectura Mixture-of-Experts (MoE) para Muse Spark Open, con 816 mil millones de parámetros totales y 42 mil millones activos por token, tiene implicaciones significativas para sus características operativas y utilidad práctica en ingeniería de software. Un diseño MoE permite fundamentalmente que un modelo posea una gran capacidad de conocimiento, representada por el recuento total del parámetro, manteniendo al mismo tiempo una huella computacional más manejable para las solicitudes individuales de inferencia. El detalle confirmado de que sólo 42 mil millones de parámetros son activos por token significa que, para cualquier token de entrada dado, sólo un subconjunto de los 'expertos' totales del modelo están comprometidos. Esta opción de diseño aborda directamente el reto de escalar modelos de lenguajes grandes: lograr una alta capacidad sin incurrir en el costo computacional prohibitivo de activar todos los parámetros para cada operación.
Desde una perspectiva de ingeniería, esta arquitectura sugiere que Muse Spark Open puede aprovechar potencialmente una comprensión amplia y profunda de los conceptos de programación, bases de códigos diversas y varios paradigmas de ingeniería de software, como lo implican sus 816 mil millones de parámetros totales. Simultáneamente, el costo de computación per cápita, más cerca del modelo denso de 42 millones de euros, indica un uso más eficiente de los recursos computacionales durante la inferencia. Esta eficiencia es fundamental para aplicaciones del mundo real, especialmente en escenarios que implican secuencias largas o altos requisitos de rendimiento, que son comunes en flujos de trabajo de codificación de agentes. Por lo tanto, la estructura del MoE permite que el modelo sea tanto completo en su base de conocimientos como relativamente eficiente en su ejecución, un equilibrio que es altamente beneficioso para las tareas complejas de desarrollo de software multipaso. Lo que no se divulgó son los mecanismos de enrutamiento específicos o el número de expertos utilizados en esta arquitectura del Ministerio de Educación, ni ningún parámetro de referencia específico relacionado con su funcionamiento del Ministerio de Educación.
Aprovechando la ventana de un millón de toneladas
La ventana de contexto confirmada de 1 millón de toneladas de Muse Spark Open representa un avance sustancial para el desarrollo de software impulsado por AI. Esta capacidad permite directamente al modelo 'ingest un proyecto entero —incluyendo dependencias, código hereditario y miles de archivos— sin dividir tareas en piezas más pequeñas", como se indica en el anuncio. Para los ingenieros de software, esta capacidad altera fundamentalmente el enfoque de proporcionar contexto para los asistentes de inteligencia artificial. Tradicionalmente, los desarrolladores han tenido que seleccionar minuciosamente y proporcionar los fragmentos de código pertinentes, documentación o diagramas arquitectónicos a un modelo de IA, a menudo limitado por límites de contexto mucho más pequeños. La ventana de 1M-token en gran medida alivia esta carga, permitiendo una comprensión más holística de una base de código.
Las consecuencias prácticas de la ingeniería son profundas. Al realizar operaciones complejas como refactores de varios archivos o sesiones de depuración, el modelo puede mantener una visión completa de todo el estado del proyecto. Esto reduce la probabilidad de introducir inconsistencias o de tener en cuenta las dependencias que podrían residir en archivos no proporcionados explícitamente en un contexto más pequeño. Por ejemplo, durante un refactor que abarca múltiples módulos, el modelo puede considerar simultáneamente las implicaciones en todos los archivos afectados, asegurando la compatibilidad de API y lógica consistente. Del mismo modo, en depuración, la capacidad de ingerir un proyecto completo permite que el modelo rastree las cuestiones en partes dispares del sistema, identificando las causas raíz que se perderían por un análisis más localizado. Esta amplia conciencia contextual apoya modificaciones de código más coherentes y fiables generadas por AI o con ayuda de AI, abordando directamente el enfoque de formación confirmado en "refactores de archivos múltiples y largas sesiones de depuración". Lo que no se reveló son características específicas del desempeño o implicaciones de latencia cuando se opera en la capacidad total de un millón de toneladas de contexto, ni limitaciones específicas sobre los tipos de archivos o estructuras de proyectos que puede ingerir.
Corrientes de trabajo de codificación y capacidades de entrada multimodal
La optimización de Muse Spark Open para 'flujos de trabajo de codificación de edad' y su capacidad confirmada para 'planear, actuar, observar resultados y autocorregir en largos horizontes' significan un movimiento más allá de la simple generación de códigos hacia una asistencia de desarrollo más autónoma e iterativa. Este paradigma agenteico implica que el modelo no es simplemente una herramienta reactiva, sino que puede involucrarse en un razonamiento multi-paso, tomar decisiones, ejecutar acciones (presumiblemente mediante la llamada de herramientas, como se confirmó), evaluar los resultados y ajustar su estrategia. Esta capacidad es particularmente valiosa para tareas complejas como "refactores de múltiples ficheros y largas sesiones de depuración", donde una sola respuesta instantánea es a menudo insuficiente. La capacidad del modelo para 'auto-correcto' sugiere un bucle de retroalimentación interna, mejorando su confiabilidad sobre las interacciones extendidas.
Seguir mejorando estas capacidades de agente es el soporte de entrada multimodal confirmado del modelo, aceptando texto, imágenes, documentos, audio y audio-vídeo. Este amplio espectro de insumos permite a los desarrolladores interactuar con el agente de IA utilizando un conjunto más rico de fuentes de información. Por ejemplo, un ingeniero podría proporcionar una descripción de un error, una imagen de un componente de la interfaz de usuario, un documento que esboza la arquitectura del sistema, o incluso una grabación de audio-vídeo que demuestra un flujo de trabajo problemático. La capacidad del modelo para procesar estos diversos insumos y generar salida de texto significa que puede sintetizar la información de diversas formas de documentación y comunicación de proyectos, lo que conduce a una comprensión más completa de la tarea a la mano. Esta capacidad multimodal, combinada con el razonamiento estadístico, proporciona una interfaz más natural y potente para problemas complejos de ingeniería de software, reduciendo la necesidad de que los desarrolladores traduzcan manualmente la información diversa en un formato puramente textual para la AI. Lo que no se reveló son las herramientas específicas que el modelo puede llamar o los mecanismos internos de sus procesos de planificación y autocorrección, ni ninguna limitación específica sobre los tipos o formatos de insumos multimodales que pueda procesar eficazmente.
Eficiencia del despliegue: Cuantización BF16 y NVFP4
La disponibilidad de Muse Spark Open en dos variantes distintas —BF16 y NVFP4 cuantificadas— aborda directamente las consideraciones de despliegue crítico para los usuarios de empresas. BF16 (BFloat16) es un formato flotante común para el aprendizaje profundo, ofreciendo un equilibrio entre la precisión numérica y la huella de memoria. Sin embargo, la variante NVFP4 introduce la cuantificación de 4 bits, que se confirma para exigir "aproximadamente una cuarta parte de la memoria" en comparación con la versión BF16. Esta reducción significativa de la huella de memoria tiene consecuencias de ingeniería directas y sustanciales, lo que afecta principalmente a la eficacia en función de los costos y la accesibilidad de la implementación de un modelo tan grande.
Para las organizaciones, el consumo de memoria es un factor principal de los costos de la inferencia, especialmente para los modelos de idiomas grandes. Al reducir los requisitos de memoria en aproximadamente un 75%, la variante NVFP4 permite el despliegue de Muse Spark Open en hardware con menos VRAM, o permite un mayor número de solicitudes de inferencia simultánea en hardware existente. Esto se traduce en una disminución de los gastos operacionales y un rendimiento potencialmente mayor, lo que hace que las capacidades avanzadas de codificación de IA sean más económicamente viables para una gama más amplia de clientes de AWS. La elección entre BF16 y NVFP4 permite a los equipos de ingeniería equilibrar la precisión y el rendimiento frente a la disponibilidad de costos y recursos. Si bien la fuente confirma la reducción de la memoria, no revela diferencias específicas de rendimiento o calidad de salida entre las variantes BF16 y NVFP4, que normalmente serían una consideración al elegir entre diferentes niveles de cuantificación. Sin embargo, el beneficio confirmado de "distribución eficiente en costos" para NVFP4 destaca su principal ventaja, infiriendo directamente su impacto en los costos operativos.
SageMaker JumpStart Integration and Control
El despliegue de Muse Spark Open a través de Amazon SageMaker JumpStart proporciona un entorno estructurado y controlado para que las empresas integren este poderoso modelo AI. El proceso de implementación confirmado de "pequeños clics" simplifica lo que de otro modo podría ser una configuración compleja que implica la provisión de infraestructura, carga de modelos y configuración de endpoint. Esta facilidad de acceso reduce la barrera a la entrada para los equipos de desarrollo que buscan experimentar con o fabricar agentes avanzados de codificación AI. Más críticamente, la confirmación de que 'el punto final que se ejecuta en su propia cuenta AWS para el control completo sobre código fuente y los impulsos' aborda preocupaciones primordiales respecto a la privacidad de datos, seguridad y propiedad intelectual.
Al asegurar que el punto final de inferencia del modelo funciona dentro de la cuenta AWS del cliente, todos los impulsos de entrada y salidas generadas permanecen dentro de los límites de seguridad definidos por el cliente. Esta es una ventaja significativa para la ingeniería de software empresarial, donde el código propietario y los detalles sensibles del proyecto se manejan rutinariamente. El "control completo del código fuente y los impulsos" implica que los clientes conservan la propiedad y la gobernanza sobre los datos que fluyen a través del modelo, que es esencial para las políticas de cumplimiento y seguridad interna. Este modelo de implementación contrasta con soluciones en las que los avisos y datos podrían ser procesados por un servicio de terceros fuera del control directo del cliente. Si bien la fuente no revela capacidades específicas de ajuste fino para Muse Spark Open, el marco general SageMaker JumpStart, combinado con el control completo sobre el punto final, proporciona una sólida base para la integración segura y coherente de la IA en los flujos de trabajo de las empresas. La capacidad de utilizar el SDK SageMaker Python también permite el despliegue y la gestión programáticas, facilitando la integración en los ya existentes o flujos de trabajo automatizados.
Consideraciones de ingeniería práctica para la adopción
Para los equipos de ingeniería de software considerando la adopción de Muse Spark Open, varias consideraciones prácticas emergen directamente de sus capacidades confirmadas. La optimización del modelo para la codificación de agentes y su ventana de contexto de 1 millón de toneladas sugieren un cambio de utilizar la IA para tareas aisladas para integrarla como un asistente más continuo y consciente de contexto. Los desarrolladores pueden explorar aprovechando su capacidad para ingerir proyectos completos para tareas que requieren un amplio entendimiento arquitectónico, como identificar preocupaciones intersectoriales durante la refactorización o el análisis del impacto de un cambio en una base de código grande. Las capacidades de entrada multimodal significan que los equipos de ingeniería pueden experimentar con la alimentación del modelo de diversas formas de información de proyectos, lo que podría simplificar el proceso de a bordo de la IA a un nuevo proyecto o tarea.
Al evaluar Muse Spark Open, los desarrolladores podrían realizar pruebas específicas. Por ejemplo, podrían evaluar su desempeño en un refactor complejo de múltiples archivos dentro de su propia base de código patentada, comparando el resultado asistido por AI con los esfuerzos manuales en términos de precisión, coherencia y tiempo ahorrado. Otra evaluación podría implicar presentar el modelo con un fallo desafiante que abarca múltiples archivos y requiere depuración iterativa, observando su "plan, act, observe, auto-correcto" bucle en acción. Probando su entrada multimodal proporcionando una combinación de código, diagramas arquitectónicos (imágenes), y documentos de diseño podrían revelar su eficacia en sintetizar información dispar. La elección entre las variantes BF16 y NVFP4 implicará un análisis de compensación entre posibles ahorros de recursos y cualquier diferencia percibida en calidad de salida o latencia de la inferencia, aunque la fuente sólo confirma la reducción de memoria para NVFP4. Lo que no se reveló son parámetros de rendimiento específicos para una variante, o guía detallada sobre cómo estructurar mejor los impulsos para un comportamiento óptimo de agente en diferentes modalidades.